 J9九游会体育
有一件事我一直合计挺反直观的。
按理说,机器东说念主要学会干活,应该是练得越多越贤慧。可实践是,那些能操控机械臂执生果、叠一稔的AI模子,练了几十万条数据后依然会在光泽一变、角度一换、桌子上多了个杯子的时候倏得失手。这不是数据不够多的问题,因为哪怕再喂它十倍的数据,这种脆弱性依然存在。问题出在更底层的地点:这些模子根蒂不知说念"宇宙会如何响应"。
这篇来自威斯康星大学麦迪逊分校和伊利诺伊大学香槟分校团队的论文,便是冲着这个structural问题去的。他们的谜底挺阴私:不去喂更多数据,而是去偷少许"宇宙不雅"过来。
**中枢问题:会作念动作的模子,不代表懂物理**
先阐述晰两个主张。
VLA模子*:Vision-Language-Action,视觉-言语-动作模子,浅显说便是看一眼场景、听一句领导,顺利吐出机械臂该往哪动的模子。它的教练样貌是看着多量东说念主类示范,学"看到这个画面,该作念这个动作",本体上是一个映射函数,输入不雅测,输转移作,中间莫得对"若是我这样作念了,宇宙会变成什么样"的建模。
这便是VLA的天生短板。它学的是"对应关联",不是"因果关联"。就像一个学生作念题只背谜底,不睬解解题过程,题型稍稍变一下就懵了。论文里提到,OpenVLA这类早期开源模子用7B参数的Llama-2作念主干,把一语气动作闹翻成token,系数预计下去,性能可以,但对环境扰动很明锐——遮拦多少许、灯光换一下,奏凯率就往下掉。
与之相对的是另一条门路:宇宙模子*:World Model,教练野心不是顺利输转移作,而是预计"异日的画面会长什么样",通常同期预计异日帧、异日情景、异日动作。这个额外的职守逼着模子必须聚拢时辰如何流动、动作会导致什么后果,是以它的里面表征自然比只会输转移作的模子更"懂物理"。
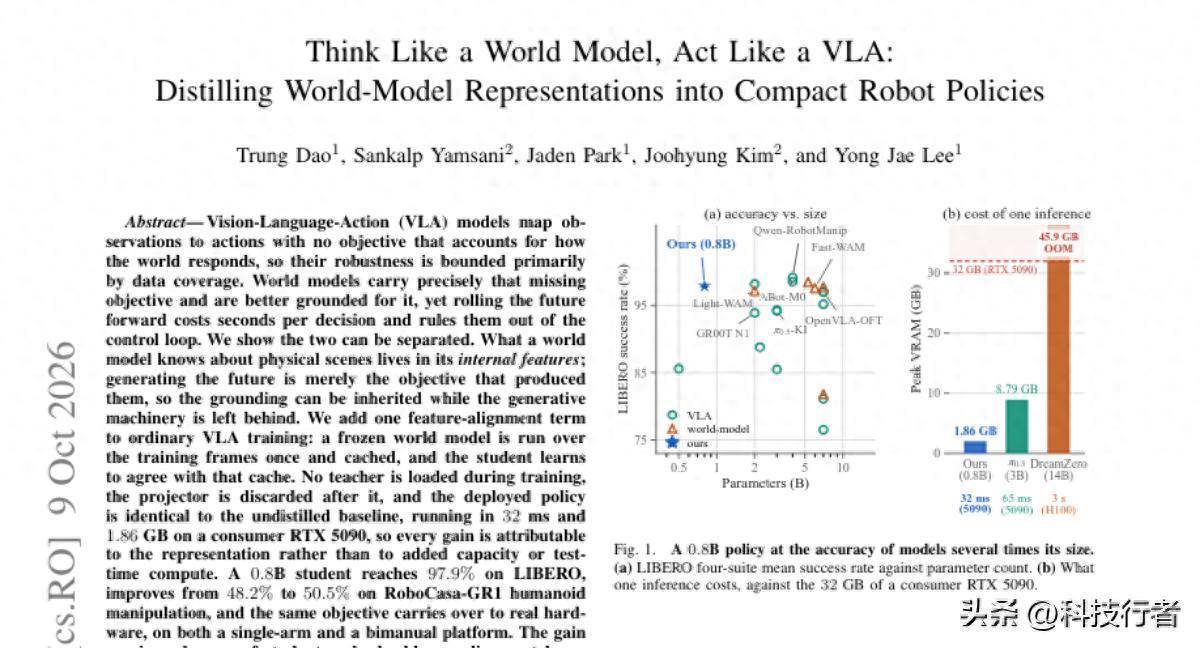
也曾有盘问评释,这类基于宇宙模子构建的计谋(论文里叫World Action Model,WAM)在新任务上的迁徙能力更强,扰动下的发达也更稳。但代价极其昂贵:DreamZero这个14B的宇宙动作模子,在H100显卡上跑一次推理要3秒,显存占用45.9GB,凡俗浮滥级显卡RTX 5090(32GB显存)根本装不下。比拟之下,π0.5这类宽广VLA只消65毫秒,本文的0.8B学生模子更是只消32毫秒,显存占用仅1.86GB。
这便是矛盾所在。宇宙模子脑子好使,但跑起来太慢太贵,没法实在部署到机械臂上及时截止。VLA跑得快,但脑子里缺一根筋。
这就好比你想雇一个既懂脸色学又能作念膂力活的保安。脸色学陶冶能一眼看透谁图谋不轨,但让他去扛麻袋,他磨疲塌蹭半天挪不动一步;壮汉扛麻袋一把好手,但对可疑东说念主物毫无察觉。若口角要在两者之间选一个,你永恒得殉难一头。盘问者们想问的是:能不可把脸色学陶冶脑子里的判断力,想主见"移植"到壮汉脑子里,而不需要壮汉果真去读四年脸色学?
**方法中枢:只学"如何想",不学"如何生成"**
论文提议的谜底是一个听起来浅显到有点朴素的想法:宇宙模子之是以懂物理,是因为它的里面特征里也曾藏着这些学问;生成异日画面仅仅产生这些特征的技能,而不是学问自己。既然学问也曾在特征里了,那就没必要让学生模子也去学着生成异日画面,顺利让学生的里面特征去"对皆"真挚的里面特征就够了。
这个操作在整篇论文里被称作表征对皆*:Representation Alignment,不要修业生输出和真挚一样的动作或画面,只消修业生某一层的里面特征在方朝上和真挚的特征保持一致。
具体如何作念的?终止看,其实是三步走。
第一步,把宇宙模子看成一个合法的"标注机器",提前跑一遍教练数据,把每一帧画靠近应的里面特征抽出来,存进一个缓存文献里。这一步完成后,真挚模子就可以澈底关掉,不再需要占用任何显存。论文里说,在LIBERO这个基准上,用四张GPU跑这个预处理大致只消一个小时。
第二步,教练学生VLA模子的时候,宽广走它我方的动作预计历程,用实在的示范动作作念监督,这部分统统不变。
第三步,额外加一个蚀本项:把学生模子某一层(论文选的是临了一层)的图像token特征,作念个均值池化,再通过一个两层MLP投影器*:一种袖珍神经网罗,崇拜把学生特征的维度退换成和真挚特征一样的维度,便捷双方作念比较,投影到真挚特征的维度上,然后猜度两者的余弦相似度蚀本*:cosine loss,谈判两个向量标的是否一致的一种蚀本函数,值域在0到2之间,越接近0阐述两个向量指向越一致。这个蚀本只消求标的一致,不要求数值统统换取,是以两个模子统统不需要用一样的网罗结构或者一样的特征维度。
这个联想里有两个细节特别值得琢磨。
一个是"冻结真挚"。教练过程中真挚模子重新到尾不会被加载进显存,因为它的输出也曾提前算好存起来了。这意味着蒸馏这件事的教练资本,和不作念蒸馏的凡俗教练资本险些一样,惟一多出来的支出便是读一个缓存文献加算一个余弦蚀本。
另一个是"标的对皆而非数值复制"。因为只消求标的一致,学生模子统统可以保留它我方动作预计所需要的额外结构,不会被真挚的特征"浑浊"或"敲诈"。这亦然为什么后头消融实验里换了三种统统不同架构的真挚模子都能成效,因为对皆的是一种概述的"物理直观",不是某个特定网罗的具体数值。
这套操作特别像补课。你请一个物理学家来给孩子讲题,但你并不要求孩子把物理学家的解题法式一字不差地抄下来,你只消求孩子临了得出的"物理直观"和物理学家的直观标的一致就行。物理学家讲完课就可以回家了,不需要每次教练都坐在孩子支配盯着。若口角要孩子统统复刻物理学家的解题过程,孩子反而可能学不会我方独处想考,教练时物理学家不在场就执瞎。而这套决策恰恰保证了:物理学家(宇宙模子)教完就走,孩子(VLA学生模子)我方独处上科场(实在部署),阐述依然踏实。
论文里主力用的真挚模子是Cosmos3-Nano*:英伟达发布的Cosmos 3宇宙模子中索求出的一个8B参数的聚拢塔(属于16B总参数的夹杂众人架构中的一部分),从中读取第24层的图像token荫藏情景,作为教学信号。这个塔自己是细目性的,不触及扩散生成那种马上采样过程,是以每次抽取的特征都是踏实的。
学生模子的主力树立是一个0.8B参数的QwenGR00T计谋*:由Qwen3-VL视觉言语主干网罗加上GR00T作风的flow-matching动作众人构成的模子架构,flow-matching是一种通过学习"噪声到野心"的速率场来生成动作序列的时间,这个学生在部署时只需要跑一次主干前向猜度加四步flow采样,推理速率和不作念蒸馏的版块统结伙样,因为对皆用的投影器和蚀本计计在推理阶段被系数丢弃了。
**实验终结:小身板打出落拓气**
数字最能阐述问题。
在LIBERO基准(一个包含空间、物体、野心、万古序四大类任务的机器东说念主操作测试集)上,这个0.8B的蒸馏学生达到了97.9%的奏凯率,比相似架构但没作念蒸馏的版块高出2.6个百分点。作为对比,表格里其他参数目在4B以下的模子,得益普遍卡在78.7%到95.3%之间,莫得一个能摸到98%。
在RoboCasa-GR1东说念主形机器东说念主操作基准上,24个任务环境,奏凯率从48.2%提高到50.5%,涨了2.3个百分点。这个提高让0.8B的小模子反超了QwenFAST、QwenPI、QwenOFT这几个4B的同门师兄,也超过了两个版块的Isaac-GR00T,距离同架构的4B版块QwenGR00T(54.8%)只差4.3个百分点,而参数目唯独对方的五分之一。
实在机械臂上的测试更有劝服力。团队在一台AgileX Nero单臂机械臂上作念了两个任务:一个是把生果捡进篮子,一个是把鸡蛋从筐里挪进篮子。前者是相对容易的执取放弃,后者因为鸡蛋光滑易滑手,对执取力度要求更暴戾。单臂捡生果任务,0.8B蒸馏模子达到93.3%的奏凯率(30次里奏凯28次),和一个4B的π作风模子打平,比未蒸馏的对照组高出3次。到了更难的捡鸡蛋任务,差距才实在露馅出来:未蒸馏版块掉到46.7%,蒸馏版块追回了4次奏凯,达到60.0%,而4B模子是70.0%。
接着团队又把生果任务搬到一台双臂平台TRIP-Bag上,改酿成一个需要两只手臂合营完成的"辛勤递生果"任务:右臂执生果,在空中递给左臂,左臂把生果放进袋子。这个转换同期换了机身、录像头、截止蔓延,用来考证蒸馏带来的收益到底是方法自己的后果,照旧只在某一套硬件上凑巧管用。终结骄气相似的排序关联保留了下来,未蒸馏版块40.0%,蒸馏版块46.7%,4B模子53.3%。
失败的案例也很有酷爱,团队专门分析了失败花样,发现问题险些都出在临了几厘米的雅致操作上:机械臂能准确找到野心物体,伸手往时标的也对,但放纵时机不合,要么提前减弱掉在中途,要么因为物体和容器边际在画面里挨得太近而执到了容器边际而不是物体自己。鸡蛋任务还多了一种失败:手指也曾合拢收拢了蛋,抬起来的过程中蛋从指缝滑走。这类失败本体上是斗争力截止的问题,不是场景聚拢的问题,团队简洁说这恰正是他们预期这套方法匡助最小的地点,因为宇宙模子对皆提高的是"聚拢物理场景"的能力,不是雅致化的力控技巧。
这个不雅察其实挺浑厚的,一个方法不可能手到病除,能阐述晰它在那边不起作用,反而更让东说念主折服它在起作用的地点是果真起作用。
**消融实验:考证这不是巧合**
一个方法要让东说念主实在信服,光靠一组排场的数字是不够的,得经得起反复折腾。论文作念了四组消融实验,逐个拆解这套方法里每个部分到底是不是必要的。
第一组换学生模子的鸿沟和主干网罗眷属,从0.8B的Qwen3.5-VL,到1B的InternVL,再到4B的Qwen3-VL,三种树立下蒸馏都带来了踏实提高,涨幅在1.6到2.5个百分点之间。这阐述投影器"自动适配维度"这个联想照实管用,不需要为每种学生模子单独休养对皆样貌。
第二组换对皆用的层,在0.8B学生模子的四分之一深度、二分之一深度、三分之二深度、临了一层之间作念扫描。终结骄气临了一层后果最佳(49.8%),但二分之一深度的层紧随自后(49.4%),差距在实验的误差范围内。团队解释说这阐述这个方法对"具体接在哪一层"不算明锐,选临了一层合法是因为工程上最省事,归正动作预计头原本就要用这一层的输出,不需要额外保留中间层的激活值。
第三组是最关节的一组:换真挚模子。团队挑升挑了两个和主力真挚Cosmos3-Nano在教练野心、网罗架构、特征维度上都截然违反的对照组:Fast-WAM(基于Wan2.2视频扩散模子的宇宙动作模子)和V-JEPA2-AC(一种自监督视频编码器加动作条目预计器的组合)。终结三个真挚全部带来提高,V-JEPA2-AC涨1.2个点,Fast-WAM涨1.6个点,Cosmos3-Nano涨2.6个点。
这少许特别缺点,因为它摈斥了一种最让东说念主顾忌的可能性:会不会这个提高仅仅因为Cosmos3-Nano这个特定真挚偶合和学生"八字很合",换个真挚就失灵了?谜底是不会。三个作风迥异的真挚都管用,阐述学生学到的不是某个特定网罗的怪癖,而是一种更普遍的、对于物理宇宙的表征先验。
这就好比你怀疑一个孩子教练跨越是不是因为气运好抽到了他刚好温习过的题型,于是你专门找了三份统统不同出题作风的试卷让他考,终结三次得益都提高了。这时候你才能实在折服,这孩子是学会了学问自己,而不是蒙对了一次考题。
写在后头
读完这篇论文,最让我合计有酷爱的少许,其实不是那些漂亮的奏凯率数字,而是它对"学问"这个东西自己的拆解样貌。
咱们通常默许,一个模子要"懂"什么东西,就得能"作念"那件事——宇宙模子懂物理,是因为它能生成异日的画面;若是你想让另一个模子也懂物理,直观上应该也让它去学生成异日画面。但这篇论文说的是,生成能力和聚拢能力其实是可以剥离的两件事,生成仅仅教练聚拢的一种技能,一朝聚拢形成了,技能就可以扔掉。这有点像你学游水是为了在水里行为自如,但一朝学会了,你有时需要每次下水前都再行履历一遍学游水的对抗过程,那种"水感"也曾内化成你肉体的一部分了。
另一个值得琢磨的细节是失败花样那部分的坦诚。团队莫得把通盘失败都归罪于方法不够好,而是精准地说出了这个方法"帮不上忙"的地点在于临了几厘米的斗争力截止。这种规模感其实比无尽吹嘘后果更有价值,因为它给后续盘问者指出了一个明确的标的:若是想措置执取鸡蛋这类雅致力控问题,可能需要一种统统不同的信号开始,而不是链接往宇宙模子对皆这条路上用力。
这篇论文也莫得回应的一个问题是,若是把多个不同类型的真挚模子同期蒸馏进吞并个学生里,会不会产生重复效应,照旧会相互打架?当今的实验只考证了单个真挚换来换去都灵验,但莫得考证"多真挚结伙教学"是否可行。这能够是留给下一篇论文的空间了。
Q&A
Q1:Think Like a World Model, Act Like a VLA这篇论文的中枢方法是什么?
A:中枢方法是给凡俗VLA教练加一个特征对皆蚀本项,让学生模子的图像特征去效法一个冻结的宇宙模子缓存下来的特征标的,不需要学生学会生成异日画面,部署时也不需要加载真挚模子,推理速率和凡俗VLA统结伙样。
Q2:为什么0.8B的小模子能追上参数目大好几倍的模子?
A:因为它通过蒸馏禁受了宇宙模子里靠近物理场景的聚拢能力,而不是单纯靠堆参数或堆数据。实验骄气这个0.8B学生在LIBERO上达到97.9%,在RoboCasa-GR1上从48.2%提高到50.5%,实在机械臂任务上也追平了4B模子的发达。
Q3:这套蒸馏方法只对特定的宇宙模子真挚灵验吗?
A:不是。论文换了三种架构、教练野心统统不同的真挚模子(Cosmos3-Nano、Fast-WAM、V-JEPA2-AC)测试J9九游会体育,全部带来稀奇益提高,阐述学到的是一种普遍的物理表征先验,不是某个特定网罗之间的巧合。